최근에 회사에서 서버 / 랙 / PoD(Point of Delivery)를 이렇게 부르고 있습니다. 여러 랙의 서버, 네트워크, 전원을 묶어 하나의 단위로 구성하고 운영하는 데이터센터의 배치 단위이고, 같은 구성의 파드를 반복해서 늘려 가는 방식으로 규모를 키운다고 알고 있습니다. 쿠버네티스의 Pod와는 다른 의미입니다. 단위의 시스템에 대한 관측 가능성을 수립하고, 이를 시스템화하는 일을 하고 있다.
관측 가능성에 대한 고민은 사실 커리어 초창기부터 이어져 오고 있는데...
- CDN 서비스 운영시스템을 만들면서, 세계 각지에 흩어진 CDN 구성요소들의 정상 상태를 잘 보기 위한 고민
- 수천 대 규모의 하이퍼바이저와 수만 개의 VM 인스턴스가 돌아가는 프라이빗 클라우드 서비스를 만들고 운영하던 일
- 다양한 마이크로서비스들의 관측 가능성을 달성하기 위해 Service Level Indicator의 줄임말로, 서비스가 잘 동작하고 있는지를 숫자로 나타내는 지표입니다. 보통 "전체 요청 중 성공한 요청의 비율"처럼 좋은 이벤트 / 전체 이벤트의 형태로 정의하는 경우가 많습니다. 체계를 수립하는 일
- 그리고 지금은 데이터센터의 관측 가능성까지
SLI를 다루는 계층은 서비스에서 다시 인프라로 내려왔지만, "무엇을 기준으로 잘 동작하고 있다고, 혹은 고장 났다고 말할 수 있을까?"라는 질문은 같고, 어떤 환경에서나 같은 전략으로 접근할 수 있지 않을까 한다.
다만 출발점은 환경마다 다르다. 보통 웹 서비스들에 대해서는 요청에 대한 실패를 가지고 드릴다운해 나가면서 SLI를 만들어 나가다 보니
출발점은 비교적 명확한 편이라고 생각한다. (안타까운 건 출발점만 명확함)
데이터센터 인프라는 기본적으로 99.99% 가동률을 목표로 부품들이 설계되고 배치가 되다 보니... 웬만해선 실패를 겪을 일이
많이 없어서... SLI 체계를 잡는다는 것이 생각보다 어렵다. (웬만해서 박살이 나지 않으니...)
그래서 이번에는 실패를 겪기 전에 무엇이 실패인지부터 정의해 볼 수 있는 일어나면 안 되는 사건 하나를 맨 위에 두고, 그 원인을 AND / OR 게이트로 이어 가며 아래로 분해해 보는 신뢰성 분석 기법입니다.를 기반으로 SLI들을 도출해 보면서, 관측 가능성 체계를 잡아 나가고 있는데 이 과정에서 겪은 일들과 고민들을 정리해 보았다.
- 서버 / 랙 / 파드 단위 컴퓨팅 시스템 고장을 Fault Tree로 분해하고,
- 트리에서 워크로드가 실제로 체감하는 지점을 골라 SLI로 세우고,
- 그 트리가 Service Level Objective의 줄임말로, SLI가 일정 기간 동안 지켜야 하는 목표치입니다. 예를 들면 "28일 동안 요청 성공률 99.9% 이상" 같은 식으로 정하고, 목표치 아래로 내려가도 괜찮은 여유분을 에러 버짓이라고 부릅니다.와 SLO를 기준으로 허용되는 실패의 양입니다. 예를 들어 SLO가 99.9%라면 나머지 0.1%만큼은 실패해도 되는 예산으로 보고, 이 예산을 얼마나 빨리 쓰고 있는지에 따라 알림을 보내거나 작업 속도를 조절합니다.을 정할 때 알려 주는 것
을 순서대로 풀어 본다. 트리 말단의 SLI를 실제로 정의하고 레코딩 룰과 알림으로 옮기는 과정은 다음 글에서 따로 정리한다.
이 글에서는 관측 도구나 SLI/SLO 개념 자체에 대한 소개는 많지 않습니다.
모니터링은 운영하고 있지만 SLI/SLO를 체계적으로 세워 본 적은 없는 분들이나, 인프라 계층에서 어떤 지표를 기준으로 삼아야 할지 고민하는 분들에게 조금 더 도움이 될 것 같습니다.
정답이라기보다는 직접 부딪혀 가며 정리한 내용에 가깝습니다. 다양한 의견과 잘못된 내용에 대한 수정은 댓글로 알려 주시면 더 공부해 보도록 하겠습니다.
FTA(Fault Tree Analysis) 간단 정리
FTA는 1960년대 초 Bell Labs에서 미 공군 미니트맨 미사일의 발사 제어 시스템을 분석하기 위해 만들어졌고, 이후 항공, 원자력 같은 분야에서 신뢰성 분석 기법으로 널리 쓰이고 있다.
방법 자체는 단순하다. 일어나면 안 되는 사건 하나를 맨 위에 두고, "이 일이 일어나려면 무엇이 일어나야 하는가?"를 반복해서 물으며 아래로 내려간다.
말로 보는 것보다 직접 눌러 보는 쪽이 감이 빨리 와서, 먼저 아래 트리를 만져 볼 수 있게 두고, 개념은 옆 탭에 정리해 두었다.
직접 해 보기
이런 순서로 눌러 보시면 게이트마다의 차이가 잘 보일 것 같습니다.
- PSU(Power Supply Unit)는 서버에 전원을 공급하는 장치입니다. 서버에는 보통 PSU를 두 개 넣어 이중화하는데, 여기서는 그 둘을 PSU-A, PSU-B로 부릅니다.만 고장 내 보기: 전원 상실은 AND 게이트라서 아직 아무 일도 일어나지 않습니다.
- PSU-B까지 고장 내 보기: 두 경로가 모두 끊겨야 전원 상실이 일어나고, top event까지 전파됩니다.
- 초기화하고 팬만 고장 내 보기: OR 게이트라서 이것 하나만으로도 top event가 일어납니다.
정리하면, AND 게이트는 아래 사건이 "전부" 고장 나야 위로 번지고, OR 게이트는 "하나만" 고장 나도 위로 번집니다.
개념 정리
항목에 마우스를 올리거나 눌러 보시면 그림에서 해당 부분이 강조됩니다.
- Top event: 분석의 출발점이 되는, 일어나면 안 되는 사건
- Intermediate event: 중간 단계의 사건. 다시 하위 사건들로 분해된다
- Basic event: 더 이상 분해하지 않는 말단 원인
- OR 게이트: 하위 사건 중 하나만 일어나도 상위 사건이 일어난다
- AND 게이트: 하위 사건이 모두 일어나야 상위 사건이 일어난다
- 최소 컷셋: top event를 일으키는 basic event의 최소 조합. 이 트리에서는
{PSU-A 고장, PSU-B 고장}처럼 함께 일어나야 하는 조합이다 - 단일 장애점: 크기가 1인 최소 컷셋. 이 트리에서는
{팬 고장}하나만으로 top event가 일어난다
부품 하나하나의 고장 모드에서 시작해 위로 올라가는 FMEA(Failure Mode and Effects Analysis)와는 방향이 반대인데, FTA는 "우리가 막고 싶은 결과"에서 시작하기 때문에 관측의 기준을 세우는 데 더 잘 맞는다고 생각했다.
트리가 있으면 고장이 얼마나 자주 일어날지도 어림해 볼 수 있다.
- AND 게이트로 묶인 이중화: 두 부품이 동시에 고장 나야 하니 아주 드문 일이 된다.
- OR 게이트: 하나만 고장 나도 되니 그만큼 흔한 일이 된다.
다만 이 어림은 부품들이 서로 독립적으로 고장 난다는 가정 위에 서 있다. 인프라에서는 이 가정이 깨지는 지점이 곧 취약한 지점이 된다.
- 이중화해 둔 부품들이 같은 전원 피드나 같은 스위치를 함께 쓰고 있다면, 독립이라는 가정이 깨진다.
- 이때는 거의 일어나지 않아야 할 동시 고장이 공통 원인 하나로 한꺼번에 일어난다.
이 얘기는 뒤의 서버 고장 트리에서 다시 한다.
메트릭이 아니라 실패에서 출발하기
처음 시작은, 겪어 본 실패에서 출발하기 어려우니 구성요소들을 하나씩 파헤쳐 가며 SLI들을 선정해 보는 일이었다. 서버 / 랙 / 파드 각 단위의 Bill of Materials의 줄임말로, 장비를 이루는 부품 목록입니다. 서버라면 CPU, 메모리, 디스크, NIC, PSU, 팬 같은 부품과 수량이 들어가고, 랙이라면 서버와 스위치, PDU 같은 구성이 들어갑니다.부터 찾고, 거기서 관측할 수 있는 대상들을 발라낸 다음, 구성요소 단위로 묶었다. 대략 이런 형태.
- 서버의 기본 컴포넌트(CPU, 메모리, 디스크)
- NIC나 서버에 장착해서 AI 학습이나 추론 같은 연산을 처리하는 가속기입니다. GPU(Graphics Processing Unit)는 원래 그래픽 처리용으로 시작해 범용 병렬 연산에 널리 쓰이고, NPU(Neural Processing Unit)는 신경망 연산에 특화되어 있습니다. 같은 장치
- 스위치, Power Distribution Unit의 줄임말로, 랙 안의 서버들에 전원을 나눠 주는 장치입니다. 보통 랙마다 A, B 두 계통의 PDU를 두고 서버의 PSU 두 개를 각각 다른 PDU에 연결해서 전원을 이중화하는데, PDU로 전원이 들어오는 각 경로를 피드라고 부르는 것으로 알고 있습니다., 공조 같은 시설 부분
이렇게 묶은 단위 하나하나가 뒤에서 그릴 고장 분해 트리의 서브 트리가 된다. 물론 BOM에 있는 것을 전부 자동으로 볼 수 있는 건 아니다. 자동화해서 볼 수 없는 부분들도 분명히 있는데, 이 이야기는 뒤에서 다시 한다.
아무튼 이렇게 BOM에서 측정할 수 있는 것들을 뽑아보면 지표들이 굉장히 많이 튀어나온다. Baseboard Management Controller의 줄임말로, 서버 메인보드에 붙어 있는 관리용 컨트롤러입니다. OS와 상관없이 전원, 팬, 온도 같은 하드웨어 상태를 원격으로 확인하고 제어할 수 있습니다.가 알려 주는 전원, 팬, 온도 센서 값부터 노드의 NIC 링크 상태, Top of Rack의 줄임말로, 랙 맨 위에 두고 그 랙 안의 서버들을 연결하는 스위치입니다. 랙의 서버들은 이 스위치를 거쳐 상위 네트워크로 나가기 때문에, 보통 두 대를 두어 이중화하는 경우가 많습니다. 스위치의 포트 상태, PDU의 피드별 전력까지, 마음만 먹으면 대시보드는 금방 가득 차서 스팸화되어 버리기 쉽다.
이런 지표를 그대로 SLI로 삼기는 어렵다. 예를 들면 이런 것들인데,
- 메모리 사용률이 xx% 이상
- 온도가 xx도 이상
- 링크 하나가 내려감
이런 사실만으로는 그 위의 워크로드가 실제로 영향을 받았는지 알 수 없고, 이중화가 잘 되어 있을수록 더 그렇다. 이런 지표들은 원인을 좁히거나 미리 손을 쓰는 데는 쓸모가 있지만 그 자체로 워크로드가 실패했다는 뜻은 아니다.
이 상태로 발굴한 모든 지표 하나하나에 임계치를 걸기 시작하면 알림이 쓸데없이 많이 늘어나는데, 정작 "지금 이 파드는 괜찮은가?"에는 답하기 어려워진다.
중요한 건 "메트릭"과 "SLI"가 어떻게 다른지 이해하고, 둘을 분리해서 다룰 수 있어야 한다는 점입니다.
이 이야기는 예전 회사 밋업에서 멋진 운영 경험을 위하여: Prometheus 레코딩 룰로 SLI 정하기라는 주제로 발표할 때도 다룬 적이 있어서, 함께 참고해 보시면 좋을 것 같습니다. (발표 자료)
결국 "어떤 메트릭을 볼까?"에서 출발하면 수집할 수 있는 지표 목록만 계속 길어진다. 그래서 순서를 뒤집어서, 무엇을 실패라고 부를지를 먼저 정하고 거기서부터 원인 쪽으로 내려가 보기로 했다. 앞에서 정리한 FTA가 바로 이렇게 결과에서 원인으로 내려가며 고장을 분해하는 도구다.
FTA를 하고 나면 "무엇이 고장인가"에 대한 정의와 그 원인들이 하나의 고장 분해 트리로 남는데, SLI와 모니터링 체계를 세우는 출발점이라고 생각한다.
인프라에 적용하기
실제로 서버 / 랙 / 파드에 FTA를 적용해 보면서 지키려고 했던 건 크게 세 가지인데...
1. "뭐가 고장 났나"보다 "뭘 못 하게 됐나"
"서버가 고장 났다"를 top event로 잡으면, 결국 서버 상태 지표를 줄줄이 늘어놓는 것과 별로 다르지 않으므로 서버를 쓰는 쪽이 실제로 겪는 일이 top event가 되는 것이 좋다고 생각했다.
- 서버가 접속이 안 된다
- 네트워크가 안 된다
- NPU/GPU를 쓸 수 없다
이렇게 잡아 두면 트리에서 나온 지표가 "그래서 워크로드가 영향을 받았나?"에 바로 답해 준다.
2. 두 개면 AND, 하나면 OR
- PSU가 두 개 꽂힌 서버라면, 둘 다 죽어야 전원이 나간다. -> AND 게이트 (흔한 High Availability(고가용성)의 줄임말로, 같은 역할을 하는 구성요소를 둘 이상 두어서 하나가 고장 나도 서비스가 계속 돌아가게 하는 구성입니다. 구성)
- 하나뿐인 부품은 고장 나는 순간 바로 끝이다. -> OR 게이트 아래에 바로 붙인다
3. 볼 수 있고 손쓸 수 있는 데까지만 내려가기
트리는 마음만 먹으면 끝도 없이 파고 내려갈 수 있다... 그런데 PSU 안의 부품까지 내려가 봐야, 운영하는 입장에서 할 수 있는 건 결국 PSU 교체인데... 그래서 아래 두 질문에 답이 나오는 데까지만 내려가고, 그 아래는 블랙박스로 두었다. (우리 문제도 아님)
- 이걸 관측할 수 있나?
- 일어나면 뭔가 할 수 있나?
PSU가 고장 났다는 건 BMC로 보이고 교체로 대응할 수 있지만, 그 안에서 어떤 부품이 망가졌는지까지는 들여다보지 않는다는 뜻이다. 부품별 고장률 같은 숫자도 처음부터 갖추기는 어려워서, 일단은 트리 모양과 컷셋만 보고 무엇을 볼지 정했다. 그것만으로도 충분했다.
Yak shaving. 원래 하려던 일을 하려다 보니 그 일에 필요한 다른 일을, 또 그 일에 필요한 다른 일을 줄줄이 하게 되면서 정작 원래 목적에서 멀어지는 상황을 가리키는 말입니다. 하지 않도록 조심해야 함.
세 원칙으로 그려 본 서버 고장 트리
서버 하나만 놓고 보면 전원도, 네트워크도 이중화되어 있으니 꽤 튼튼해 보인다. 하지만 Minimal cut set. top event를 일으키는 basic event의 최소 조합입니다. 조합에 든 사건이 모두 일어나면 top event가 일어나고, 하나라도 빠지면 일어나지 않습니다. 크기가 1인 최소 컷셋은 그 사건 하나만으로 top event가 일어나는 단일 장애점입니다.을 뽑아 보면 이야기가 조금 달라진다.
- 흡기 온도 상승
- 크기가 1인 단일 장애점이다.
- 냉각 문제 하나로 이 서버가 내려가고, 같은 랙(혹은 같은 열)의 서버들도 같은 시점에 함께 내려간다.
- 랙 PDU-A + 랙 PDU-B, ToR 스위치 A + ToR 스위치 B
- 서버 입장에서는 이중화된 경로라서, 하나만 끊기는 건 괜찮다.
- 다만 랙 안의 모든 서버가 같은 두 피드와 같은 두 스위치를 공유한다.
- 문제는 둘이 함께 끊길 때다. 그러면 랙 전체가 한 번에 내려간다. 한쪽이 점검으로 비어 있거나 한쪽 PDU가 죽어 남은 쪽에 부하가 몰리는 경우처럼, 이런 일이 일어날 가능성도 생각보다 크다.
- PSU-A + 랙 PDU-B
- PSU-A가 이미 죽어 있는 서버는, 랙 PDU-B 피드 점검처럼 계획된 작업만으로도 내려간다.
- 평소에는 이중화 덕분에 아무 문제가 없어 보이기 때문에, 이런 서버는 점검 직전까지 드러나지 않는다.
색을 칠한 사건들이 앞에서 말한 독립 가정이 깨지는 지점이다. 이런 사건은 두 가지 면에서 문제가 되는데...
- 어림: 서버들이 서로 독립적으로 고장 난다고 보면, 랙 단위 동시 장애를 크게 과소평가하게 된다.
- 관측: 서버 단위 지표만 보고 있으면 "서버 여러 대가 비슷한 시간에 장애"로만 보이고, 하나의 원인이라는 사실이 잘 드러나지 않는다.
한편으로는, 이렇게 서버들의 공통분모를 모아 보면 랙의 최소 컷셋으로 가져갈 수 있는 가능성도 생긴다. "랙 전체가 내려간다"를 랙 수준의 top event로 놓으면, 흡기 온도 상승 하나, PDU 두 개의 조합, ToR 스위치 두 개의 조합이 각각 그 최소 컷셋이 되기 때문이다.
직접 해 보기
이런 순서로 눌러 보시면 공통분모가 랙 전체로 번지는 모습이 잘 보일 것 같습니다.
- PDU-A만 끊어 보기: 서버마다 PDU-B로 버티기 때문에 아직 아무 일도 일어나지 않습니다.
- PDU-B까지 끊어 보기: 서버 하나하나의 이중화와 상관없이 네 대가 한꺼번에 내려갑니다.
- 초기화하고 흡기만 고장 내 보기: 흡기는 하나뿐이라 이것 하나로 랙 전체가 내려갑니다.
그림의 번호는 옆 탭에 있는 랙 수준 트리의 최소 컷셋 번호입니다.
랙 수준 FTA
이렇게 이중화되어 있다고 생각했던 곳이 실제로는 같은 원인을 공유하고 있는 경우를 찾아내는 것이 FTA를 해 볼 만한 가장 큰 이유였다. 구성은 단순화했지만, 실제로 트리를 그리면서 마주친 모습도 이와 크게 다르지는 않았다.
그래서 트리를 SLI로 옮길 때는 서버 하나의 상태뿐 아니라, 같은 원인을 공유하는 단위로도 묶어 볼 수 있어야 한다. 이 부분은 다음 장의 묶음 규칙으로 이어진다.
고장 트리에서 SLI 수립하기
여러 관측 대상에 대해 고장 분해 트리를 그려 놓고 나면, top event 아래로 중간 사건이, 그 아래로 basic event가 매달린 모양이 된다. 이제 이 자리마다 SLI를 붙이고, 그것들을 다시 쓸모 있는 단위로 묶을 차례다.
트리와 SLI의 대응
SLI는 두 방향에서 나온다.
- 위에서 아래로: "서버가 접속이 안 된다" 같은 top event에서 출발
- 아래에서 위로: BOM에서 발라낸 구성요소 메트릭 중 주요 지표를 SLI로 격상
트리는 이 두 방향을 한자리에 모아 준다. 트리의 자리마다 붙는 SLI가 다르다.
| 트리에서의 자리 | 붙는 SLI |
|---|---|
| top event | 서비스 SLI |
| 중간 사건 | 계층 묶음 |
| basic event | leaf SLI |
게이트 자리에는 SLI가 따로 붙지 않는다. 예를 들어 OR 게이트는 아래 중 하나라도 실패하면 실패로 보는, 묶는 규칙이 된다.
아래에서 위로 격상한 지표들이 바로 basic event에 붙는 leaf SLI다. 다만 leaf SLI는 메트릭에 임계치를 하나 걸어 둔 것과는 다르다. 무엇을 하나로 셀지, 언제 위반으로 볼지, 무엇을 빼고 셀지까지 정해야 비로소 SLI가 된다.
그리고 leaf를 전부 같은 무게로 OR에 묶으면 앞에서 말한 노이즈 문제가 그대로 돌아온다. PSU 하나가 고장 난 것과 전원이 완전히 끊긴 것이 똑같이 "서비스 위반"으로 잡히기 때문이다. 그래서 leaf를 두 축으로 다시 묶었다.
두 축으로 다시 묶기
계층 축은 같은 계층의 leaf를 묶는다. 서버 고장 트리라면 전원, 네트워크, 냉각이 계층이 되고, 실제로는 앞에서 BOM을 구성요소 단위로 묶은 것이 그대로 계층이 된다. 계층 묶음은 "어느 계층이 문제인가"를 좁히는 데 쓴다.
유형 축은 leaf가 무엇을 묻는지에 따라 묶는다. 실제로는 유형이 몇 가지 더 있지만, 여기서는 대표적인 두 가지만 예로 든다.
| 유형 | 묻는 것 | 서버 고장 트리에서 | 모이는 곳 |
|---|---|---|---|
| 장애 | 지금 쓸 수 없는가 | 전원 상실, 네트워크 단절, 과열 보호 동작 | 서비스 가용성 |
| Headroom. 한계까지 남아 있는 여유분을 가리키는 말입니다. 여기서는 다음 고장이 와도 버틸 수 있는 여유, 예를 들어 이중화가 아직 살아 있는지를 뜻합니다. | 다음 고장을 버틸 여유가 남았는가 | PSU 하나 고장, 업링크 하나 단절, 흡기 온도 경고 | 서비스 헤드룸 |
| ... | ... | ... | ... |
- 장애 유형: 서비스가 실제로 깨졌다는 뜻이라, 빠르게 나빠지면 사람을 부른다.
- 헤드룸 유형: 아직 깨지진 않았지만 여유가 줄고 있다는 조기 경보라, 경고 이상으로는 올리지 않는다.
예를 들어 PSU-A가 고장 나면 워크로드는 PSU-B로 버티지만 단일 장애점이 하나 생긴다. 이런 이중화 상실은 헤드룸 leaf만 위반이라 서비스 가용성은 그대로이고, 정해진 시간 안에 고치면 되는 작업으로 남는다. 실제로도 이런 헤드룸 유형 위반은 경고 채널로 알림을 보내고, 담당자가 확인해서 처리하고 있다.
마지막으로, 관리망과 메타는 서비스 top event 밖에 따로 묶는다. 서비스는 멀쩡한데 이것들 때문에 서비스 SLI가 흔들리면 안 되기 때문이다.
- 관리망(Out-of-Band의 줄임말로, 서비스 트래픽이 다니는 망과 따로 떼어 둔 관리용 망입니다. 반대로 서비스 트래픽이 흐르는 쪽은 IB(In-Band)라고 부릅니다. 서버의 BMC나 장비의 관리 포트가 OOB에 연결되어 있어서, 서비스 망이 끊겨도 원격으로 상태를 보고 제어할 수 있습니다.): 끊겨도 워크로드는 계속 돌지만, 원격으로 상태를 보고 제어하는 운영 능력을 잃는다.
- 메타: 관측 체계 자체다. 다른 판정을 믿을 수 있는지를 본다.
메타를 따로 두는 건 관측이 안 되는 상태 때문이다. BMC나 스위치도 결국 고장 날 수 있는 구성요소라서, 신호가 끊겼다고 해서 서버가 고장 났다고 볼 수는 없다.
- 신호가 없는 시간을 정상으로 세면: SLI가 실제보다 좋아 보인다.
- 고장으로 세면: 관측 시스템의 문제가 인프라의 고장으로 둔갑한다.
그래서 관측되지 않은 시간은 위반에서도, 전체에서도 뺀다. 다만 빼기만 하면 관측 공백이 SLI 뒤에 숨어 버리기 때문에, 그 시간은 메타 쪽에서 따로 센다.
묶을 때의 규칙
leaf를 묶은 것(계층 묶음, 서비스 가용성, 서비스 헤드룸)을 다룰 때 지키는 원칙이 두 가지 있다.
알림은 leaf에 건다. 무엇이 깨졌는지 바로 드러나는 곳에서 울려야 대응이 빠르다. 묶음은 한눈에 보는 용도로 쓴다.
leaf를 하나만 고장 내 보시면, 알림은 그 leaf에서만 울리고 전원 묶음은 위반으로 표시만 되는 것을 볼 수 있습니다. 알림만 보고도 무엇을 고쳐야 할지 바로 알 수 있도록, 알림은 leaf에 걸어 두었습니다.
같은 사건은 한 번만 센다. 예를 들어 랙 PDU 피드가 끊기면, 같은 장애가 서버 쪽(그 랙 서버들의 전원 leaf)과 시설 쪽(PDU 피드 leaf) 두 군데서 동시에 잡힌다. 둘을 같은 묶음에 넣으면 같은 사건을 두 번 세게 되므로, 시설 쪽 leaf는 서버 묶음에 섞지 않고 앞의 랙 수준 트리에서 따로 본다. 알림은 leaf마다 따로 울리더라도, 묶음의 숫자에는 같은 사건이 한 번만 들어가야 한다.
피드를 끊어 보시면 같은 장애가 서버와 시설 두 군데서 동시에 잡히고, 왼쪽은 시설 쪽을 한 번 더 세는 반면 오른쪽은 시설 쪽을 랙 수준 트리에서만 세는 것을 볼 수 있습니다.
정리하면, 데이터센터가 고장 났다고 말할 수 있는 건, 그 위에서 돌아가는 워크로드가 할 일을 못 하게 됐을 때다. 트리로 말하면 top event가 일어났을 때이고, 그 아래에서 헤드룸이 줄어드는 건 아직 고장이 아니라 다음 고장을 버틸 여유가 줄었다는 신호다.
트리가 목표치에 알려 주는 것
SLO와 에러 버짓, 알림을 세우는 과정은 다음 글에서 따로 정리하고, 여기서는 트리가 있어서 보이는 두 가지만 짚어 둔다.
위쪽 목표치에는 상한이 있다. 묶음은 멤버 중 하나라도 위반이면 위반으로 보기 때문에, 위쪽의 가용성은 아래쪽 것들보다 좋을 수 없다. 예를 들어 서버가 정상이려면 전원, 네트워크, 냉각이 모두 정상이어야 하는데, 셋이 각각 99.9%이고 서로 독립이라면 서버는 대략 99.7%가 된다. 셋이 함께 고장 나는 경우가 많을수록 조금 나아지지만, 어떤 경우에도 가장 낮은 99.9%를 넘을 수는 없다. 위쪽 목표를 이보다 높게 잡고 싶다면, 숫자를 정하기 전에 트리의 어느 쪽을 보강할지부터 정해야 한다.
공통 원인은 버짓을 한 번에 쓴다. 설명을 위해 숫자를 임의로 잡아 보면, 서버 1,000대짜리 파드에 28일 동안 99.9%를 목표로 잡을 때 에러 버짓은 서버 한 대를 28일 내내 꺼 둘 수 있는 양이다. 그런데 서버 40대짜리 랙 하나가 통째로 내려가면 이 버짓을 약 17시간 만에 다 쓴다. 평균으로 보면 같은 양이라도 공통 원인은 버짓을 한 번에 크게 쓰기 때문에, 서버 고장 트리에서 색을 칠한 사건들을 따로 챙겨야 한다.
트리로 다 볼 수 없는 것들
트리를 그려 두어도, 관측할 수 없는 부분에서 오는 장애는 남는다. 앞에서 말한, 자동화해서 볼 수 없는 부분들이다. 트리에 사건으로는 그려 둘 수 있어도 판정할 신호가 없는 경우인데, 인프라 쪽에서는 보통 이런 것들이 어렵다.
- 간헐적인 품질 저하: 링크가 잠깐씩 흔들리거나 광모듈이 서서히 나빠지는 것처럼, 상태 값은 정상인데 실제로는 문제가 있는 경우다. "정상이면 1"로 노출되는 신호로는 잡히지 않는다.
- 시설 쪽 신호: 공조나 전력 설비는 IT 장비와 다른 체계로 관리되는 경우가 많아서, 그 신호를 IT 쪽 수집 체계에서 바로 받기 어렵다. 이럴 때 트리는 흡기 온도 상승이나 피드 상실 같은 basic event에서 끝나고, 그 너머는 보이지 않는다.
- 워크로드에서만 보이는 증상: NPU/GPU 성능이 떨어지거나 잡이 멈추는 것처럼, 하드웨어 지표로는 멀쩡한데 워크로드 쪽에서만 드러나는 경우다.
이런 빈틈은 보통 몇 가지 방법을 섞어서 메운다.
- 장애를 한 번 겪고 나면, 회고에서 원인이 된 사건과 그걸 볼 수 있는 신호를 찾아 트리에 추가한다. 트리는 이렇게 조금씩 넓어진다.
- 자동으로 판정할 수 없는 부분은 사람이 주기적으로 점검한다.
- 시설이나 벤더처럼 직접 볼 수 없는 쪽은 담당 조직과의 연락 체계로 보완한다.
그래도 전부 메워지지는 않아서, 트리 밖에 남는 부분은 늘 있다.
소감
이전 경험들에서는 이미 운영 중인 시스템과 메트릭에서 출발해, 시스템을 거꾸로 더듬어 가며 SLI를 수립해 나갔다. 작은 조각들을 하나씩 맞춰 나가는 방식이었다. 또 여러 팀이 함께 얽힌 일이다 보니 각자 서 있는 자리에 따라 보는 관점과 우선순위가 조금씩 달랐고, 이를 하나의 방향으로 맞춰 가는 데에도 시간이 필요했다.
사실 이 고민은 예전 회사 밋업 발표 때도 했었는데, 그때는 "남은 과제"로 남겨 뒀었다. 복잡한 서비스 구성요소들의 Fault Tree 한가운데에 "서비스 정상이에요?"라는 질문만 하나 띄워 놓고...
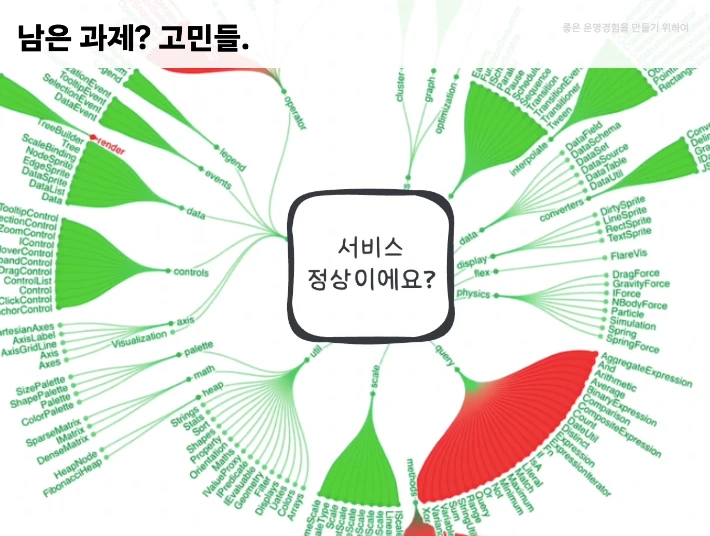
예전 발표의 '남은 과제? 고민들.' 장. Fault Tree 가운데에 질문 하나.
그때 정리한 방향은, 흩어진 생각들을 "SLI 수립"으로 한곳에 모으자는 거였다. 다만 그 파란 화살표 안을 실제로 어떻게 채울지는 그때도 숙제였다.
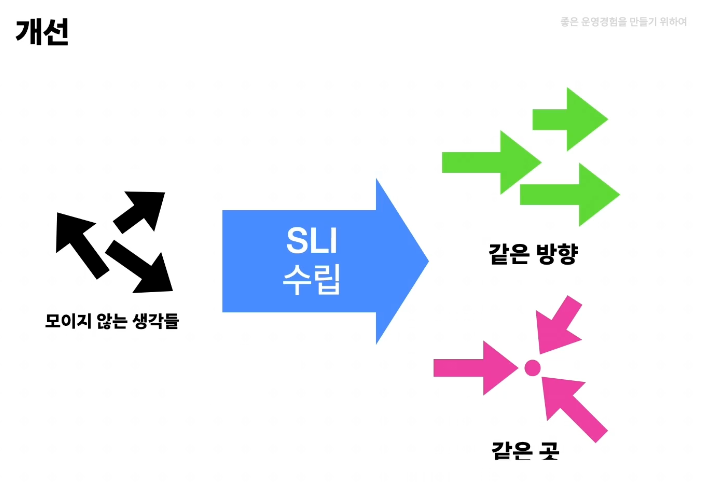
같은 발표의 '개선' 장. 모이지 않는 생각들이 SLI 수립을 지나 같은 방향, 같은 곳으로 모임.
이번 작업에서는 방법론부터 세우고, 컴포넌트의 구조를 하나씩 짚어 나가며 필요한 부분들을 함께 맞춘 다음,
그 위에서 관측 가능성 시스템을 잡아 나가고 있다.
기반이 잘 잡힌 상태에서 진행하다 보니, 생각보다 매끄럽게 각 파트의 내용들이 맞춰지고 있어서 좋다. (지금까지는...)
돌아보면 그 파란 화살표도 일종의 블랙박스였던 셈인데, 이번에는 트리를 그려 가며 그 안을 조금은 열어 본 것 같다. 밀린 숙제를 이제야 제출하는 기분이다.
이렇게 세운 Fault Tree는 장애에 대응할 때 꺼내 볼 수 있는 체계적인 멘탈 모델로 자리 잡을 수 있길 바란다. 장애가 끝난 뒤 Root Cause Analysis의 줄임말로, 장애가 끝난 뒤 근본 원인을 찾아 정리하는 분석입니다. 보통 장애 회고(포스트모템)와 함께 진행하는 것으로 알고 있습니다.를 할 때도 이 트리를 바탕으로 하면 원인을 좁혀 가기가 수월하고, 나아가 운영 전반도 더 자동화된 방식으로, 훨씬 효율적으로 돌아갈 수 있을 것이다.
다음 글에서는 이렇게 세운 트리 위에서 leaf SLI 하나를 실제로 어떻게 정의하는지,
그 판정을 Prometheus 레코딩 룰로 옮겨 SLO와 에러 버짓, 알림으로 이어 가는 과정을 정리해 보려고 한다. (언젠가...)
함께 보면 좋은 내용
- Google SRE Book - Service Level Objectives: https://sre.google/sre-book/service-level-objectives/
- Google SRE Workbook - Implementing SLOs: https://sre.google/workbook/implementing-slos/
- U.S. NRC Fault Tree Handbook (NUREG-0492): https://www.nrc.gov/reading-rm/doc-collections/nuregs/staff/sr0492/index.html
- 당근 SRE 밋업 4회 - 멋진 운영 경험을 위하여: Prometheus 레코딩 룰로 SLI 정하기: https://youtu.be/f76i29l4aGs